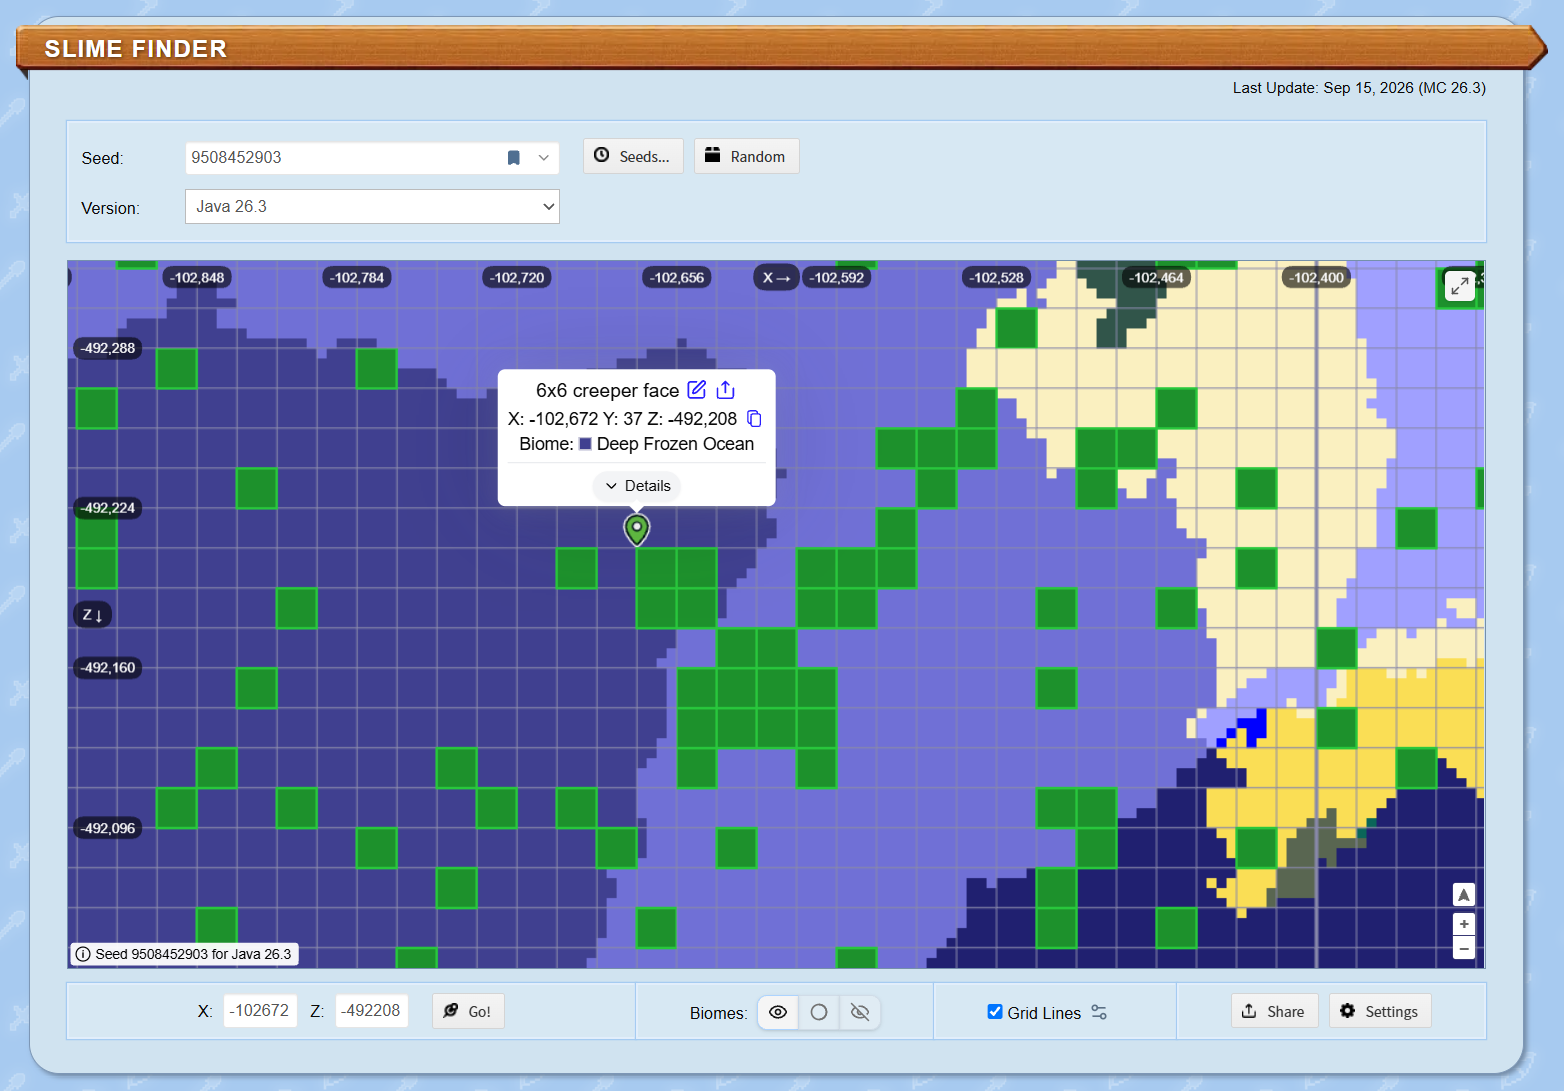
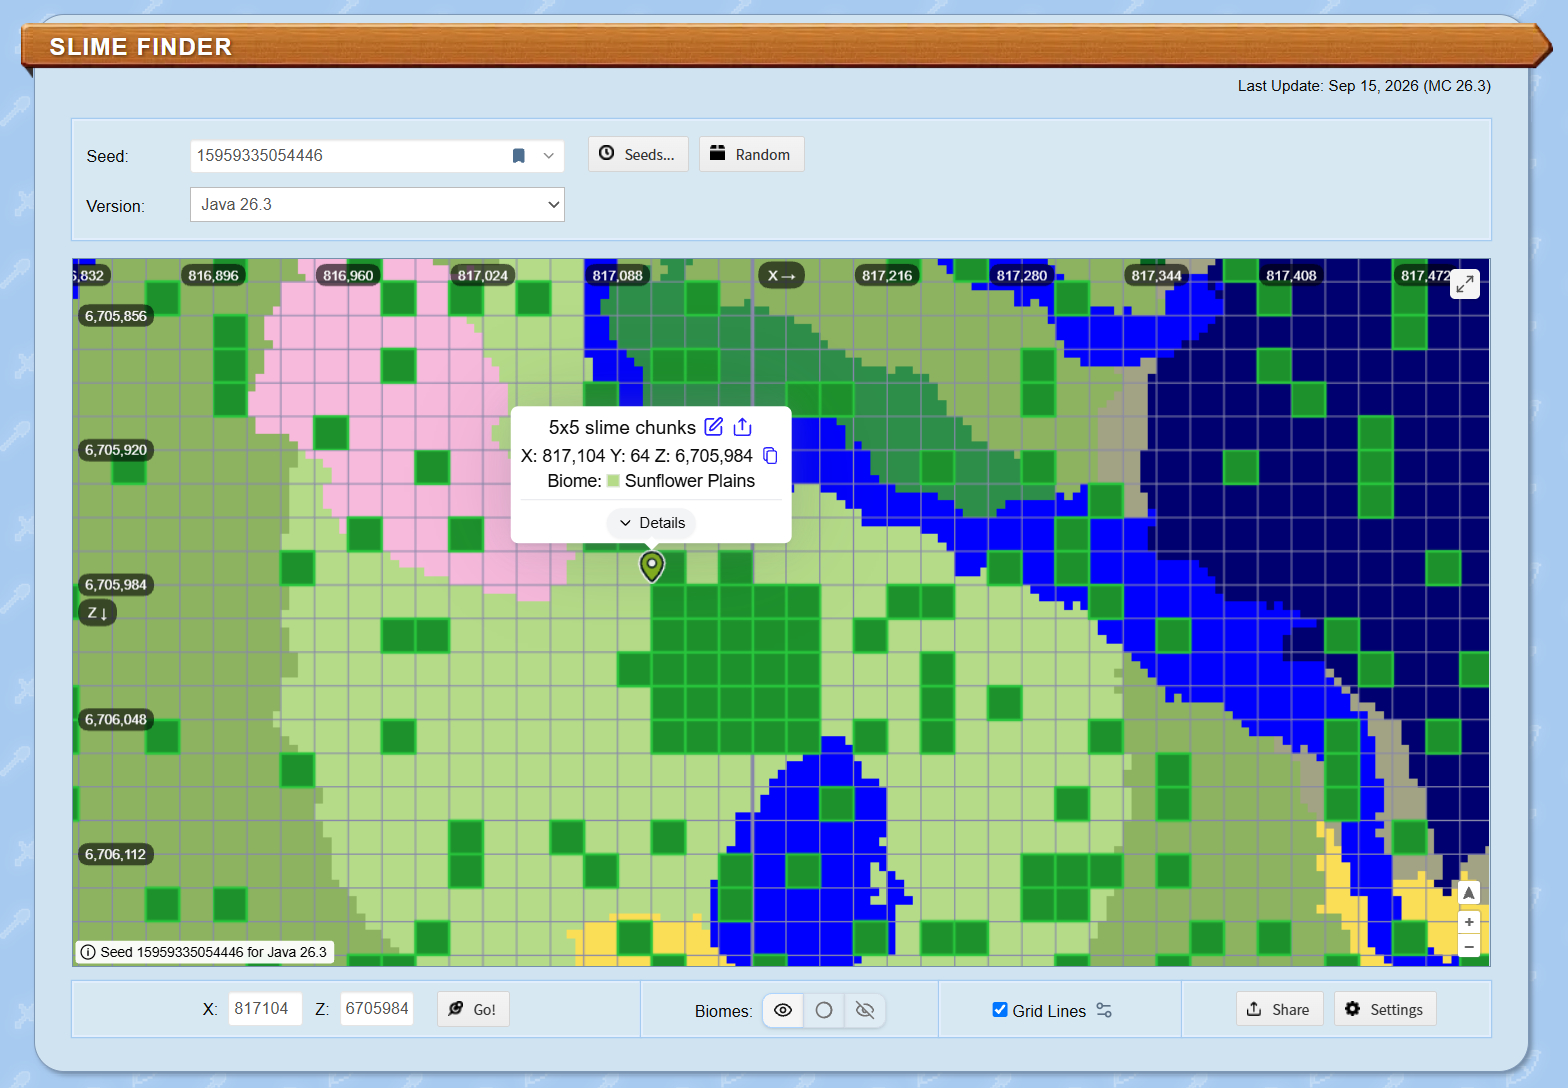
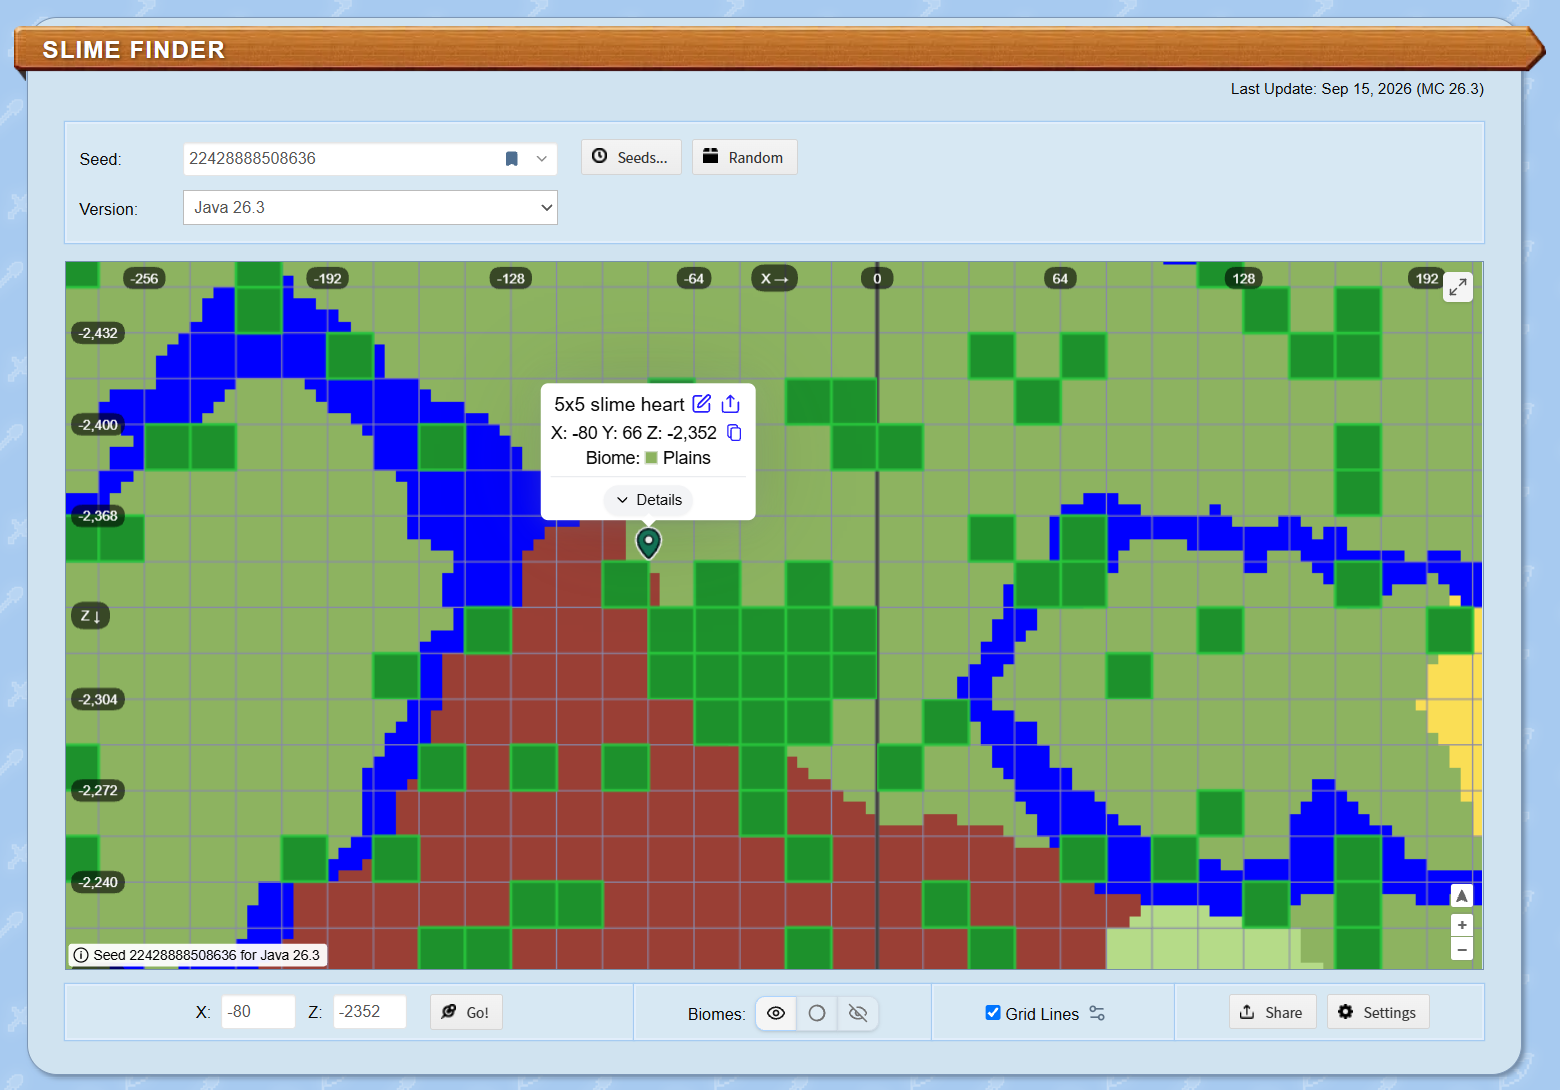
在 Minecraft 中,x z xz x z 16 × 16 16 \times 16 16 × 16 y < 40 y<40 y < 40
史莱姆区块是史莱姆农场的基础。为了效率最大化,史莱姆农场往往会在史莱姆区块密集的地方选址。例如 3 × 3 3 \times 3 3 × 3 4 × 4 4 \times 4 4 × 4 5 × 5 5 \times 5 5 × 5
本文主要介绍 Java 版史莱姆区块的生成规律和如何快速寻找特定图案的史莱姆区块。
史莱姆区块的判定
史莱姆公式
史莱姆区块的判定由世界种子 w w w 区块坐标 ( x , z ) (x,z) ( x , z ) T ( x , z ) T(x,z) T ( x , z ) Random,再调用 nextInt(10)。返回 0 就是史莱姆区块,返回 1 到 9 则不是 。也就是说,史莱姆区块的概率是 1 / 10 1/10 1/10
import java . util . Random ; boolean isSlimeChunk ( long worldSeed , int x , int z ) { return new Random ( worldSeed + ( int ) ( x * x * 4987142 ) + ( int ) ( x * 5947611 ) + ( int ) ( z * z ) * 4392871L + ( int ) ( z * 389711 ) ^ 987234911L ) . nextInt ( 10 ) == 0 ; } 先用一个记号表示 Java 有符号 32 位整数的溢出处理:保留运算结果的低 32 位,再按有符号数解释。本文的 mod 一律取非负余数。
J 32 ( ξ ) = ( ( ξ + 2 31 ) m o d 2 32 ) − 2 31 . J_{32}(\xi)=((\xi+2^{31})\bmod2^{32})-2^{31}. J 32 ( ξ ) = (( ξ + 2 31 ) mod 2 32 ) − 2 31 . 原始坐标项是:
T ( x , z ) = J 32 ( 4987142 x 2 ) + J 32 ( 5947611 x ) + 4392871 J 32 ( z 2 ) + J 32 ( 389711 z ) . T(x,z)=J_{32}(4987142x^2)+J_{32}(5947611x)
+4392871J_{32}(z^2)+J_{32}(389711z). T ( x , z ) = J 32 ( 4987142 x 2 ) + J 32 ( 5947611 x ) + 4392871 J 32 ( z 2 ) + J 32 ( 389711 z ) . x = 51069 x=51069 x = 51069 4987142 × 5106 9 2 = 13006679591179062 4987142\times51069^2=13006679591179062 4987142 × 5106 9 2 = 13006679591179062 J 32 ( 13006679591179062 ) = − 1799531722 J_{32}(13006679591179062)=-1799531722 J 32 ( 13006679591179062 ) = − 1799531722
随机数种子的公式:
( w + T ( x , z ) ) x o r 987234911. (w+T(x,z)) \mathbin{\mathrm{xor}} 987234911. ( w + T ( x , z )) xor 987234911. Random 的内部实现
下面的函数等价于 new Random(randomSeed).nextInt(10):
初始化得到 48 位状态 u u u A A A v v v q q q q % 10;若 q - value + 9 超过有符号 32 位整数的上限,就从当前状态继续重抽。
int nextInt10 ( long randomSeed ) { final long A = 0 x5DEECE66DL ; final long mask48 = ( 1L << 48 ) - 1 ; long u = ( randomSeed ^ A ) & mask48 ; while ( true ) { long v = ( A * u + 11 ) & mask48 ; int q = ( int ) ( v >>> 17 ) ; int value = q % 10 ; if ( ( long ) q - value + 9 <= 0 x7FFFFFFFL ) { return value ; } u = v ; } } 合并史莱姆公式和 Random 初始化里的两次 XOR:
A = 0 x 5 D E E C E 66 D , C = A x o r 987234911 = 0 x 5 E 434 E 432 . A=\mathtt{0x5DEECE66D},\qquad
C=A\mathbin{\mathrm{xor}}987234911=\mathtt{0x5E434E432}. A = 0x5DEECE66D , C = A xor 987234911 = 0x5E434E432 . 对单个区块 ( x , z ) (x,z) ( x , z )
u = ( ( w + T ( x , z ) ) x o r C ) m o d 2 48 , u=((w+T(x,z))\mathbin{\mathrm{xor}}C)\bmod2^{48}, u = (( w + T ( x , z )) xor C ) mod 2 48 , v = ( A u + 11 ) m o d 2 48 , v=(Au+11)\bmod2^{48}, v = ( A u + 11 ) mod 2 48 , q = v ≫ 17. q=v\gg17. q = v ≫ 17. 如果首次输出被接受,nextInt(10) 返回 q m o d 10 q\bmod10 q mod 10 q ≡ 0 ( m o d 10 ) q\equiv0\pmod{10} q ≡ 0 ( mod 10 )
朴素的爆搜
我们暂时把 Random 的数学性质按下不表,基于上面的公式,采用朴素的手段进行爆搜。
CPU:按种子枚举位置
最直接的方法是枚举世界种子和区块坐标,调用上面的判定函数。要找一片全部满足要求的区域,就检查该位置及其周围各格;只要一格失败,这个候选便可提前退出:
for worldSeed in seeds : for ( x , z ) in positions : allSlime = True for ( dx , dz ) in offsets : if not isSlimeChunk ( worldSeed , x + dx , z + dz ) : allSlime = False break if allSlime : record ( worldSeed , x , z ) 从这一节开始,会有一些实测数据。所有测试都在作者的同一台笔记本上进行,CPU 为 AMD Ryzen 7 5800H,GPU 为 NVIDIA GeForce RTX 3060 Laptop GPU。并非严谨测试,数据仅供参考。
CUDA:每个线程负责一个种子
同样的逻辑可以在 GPU 上实现。每个线程负责一个世界种子,扫描全部候选位置:
GPU thread(worldSeed): for (x, z) in positions: check and record this candidate 同样搜索 65536 个种子、257×257 个候选位置,目标都是实心 5×5。
版本 搜索时间中位数 CPU,16 个逻辑线程 3550.398 ms CUDA,每线程一个种子 111.110 ms
约加速 31.95 倍。CPU 时间包含线程创建、搜索与结果收集;GPU 使用 scan 时间,含清零、同步及回传,不含一次性的上下文创建和显存分配。
CUDA:固定坐标,在线程内遍历种子
还可以交换两层循环的分工:让一个工作单元固定一个坐标,在线程内部遍历种子。
之前:thread(worldSeed) -> 扫描全部坐标
之后:thread(x, z)      -> 遍历全部种子
交换循环后,每个位置的坐标项 T ( x , z ) T(x,z) T ( x , z ) w w w
同样搜索 65536 个种子、4097×4097 个位置、实心 5×5:
版本 GPU kernel 时间中位数 每线程一个种子 31598.539 ms 固定坐标并复用轴项 17600.387 ms
约加速 1.795 倍。
Outer Sum:相邻线程共享坐标轴项
这里还有一个优化点:相邻位置需要的 X、Z 坐标大量重叠,可以将坐标项按变量拆开:
F ( x ) = J 32 ( 4987142 x 2 ) + J 32 ( 5947611 x ) , F(x)=J_{32}(4987142x^2)+J_{32}(5947611x), F ( x ) = J 32 ( 4987142 x 2 ) + J 32 ( 5947611 x ) , G ( z ) = 4392871 J 32 ( z 2 ) + J 32 ( 389711 z ) , G(z)=4392871J_{32}(z^2)+J_{32}(389711z), G ( z ) = 4392871 J 32 ( z 2 ) + J 32 ( 389711 z ) , T ( x , z ) = F ( x ) + G ( z ) . T(x,z)=F(x)+G(z). T ( x , z ) = F ( x ) + G ( z ) . F F F G G G
X 轴项 \ Z 轴项 G ( z ) G(z) G ( z ) G ( z + 1 ) G(z+1) G ( z + 1 ) G ( z + 2 ) G(z+2) G ( z + 2 ) F ( x ) F(x) F ( x ) F ( x ) + G ( z ) F(x)+G(z) F ( x ) + G ( z ) F ( x ) + G ( z + 1 ) F(x)+G(z+1) F ( x ) + G ( z + 1 ) F ( x ) + G ( z + 2 ) F(x)+G(z+2) F ( x ) + G ( z + 2 ) F ( x + 1 ) F(x+1) F ( x + 1 ) F ( x + 1 ) + G ( z ) F(x+1)+G(z) F ( x + 1 ) + G ( z ) F ( x + 1 ) + G ( z + 1 ) F(x+1)+G(z+1) F ( x + 1 ) + G ( z + 1 ) F ( x + 1 ) + G ( z + 2 ) F(x+1)+G(z+2) F ( x + 1 ) + G ( z + 2 ) F ( x + 2 ) F(x+2) F ( x + 2 ) F ( x + 2 ) + G ( z ) F(x+2)+G(z) F ( x + 2 ) + G ( z ) F ( x + 2 ) + G ( z + 1 ) F(x+2)+G(z+1) F ( x + 2 ) + G ( z + 1 ) F ( x + 2 ) + G ( z + 2 ) F(x+2)+G(z+2) F ( x + 2 ) + G ( z + 2 )
表中每格都是对应坐标的 T T T T ( x + 1 , z + 2 ) T(x+1,z+2) T ( x + 1 , z + 2 ) F F F G G G a a a b b b a + b a+b a + b a b ab ab
类比 outer product,这种“每个横轴项加上每个纵轴项”就是 outer sum:
α ⊞ β = ( α i + β j ) m × n = ( α 0 + β 0 α 0 + β 1 ⋯ α 0 + β n − 1 α 1 + β 0 α 1 + β 1 ⋯ α 1 + β n − 1 ⋮ ⋮ ⋱ ⋮ α m − 1 + β 0 α m − 1 + β 1 ⋯ α m − 1 + β n − 1 ) \bm{\alpha}\boxplus\bm{\beta}=(\alpha_i+\beta_j)_{m\times n}=\begin{pmatrix}
\alpha_0+\beta_0 & \alpha_0+\beta_1 & \cdots & \alpha_0+\beta_{n-1} \\
\alpha_1+\beta_0 & \alpha_1+\beta_1 & \cdots & \alpha_1+\beta_{n-1} \\
\vdots & \vdots & \ddots & \vdots \\
\alpha_{m-1}+\beta_0 & \alpha_{m-1}+\beta_1 & \cdots & \alpha_{m-1}+\beta_{n-1}
\end{pmatrix} α ⊞ β = ( α i + β j ) m × n = α 0 + β 0 α 1 + β 0 ⋮ α m − 1 + β 0 α 0 + β 1 α 1 + β 1 ⋮ α m − 1 + β 1 ⋯ ⋯ ⋱ ⋯ α 0 + β n − 1 α 1 + β n − 1 ⋮ α m − 1 + β n − 1 利用这个数学性质,可以减少重复计算,让相邻线程共享各轴的计算结果。
本组将种子数量设为 1,扫描 32769×32769 个位置,共 1,073,807,361 个候选,目标仍为实心 5×5:
版本 GPU kernel 时间中位数 线程私有轴项 40.350 ms outer sum 共享轴项 23.767 ms
约加速 1.698 倍。
Random 的数学性质
随机数重试
拒绝采样的原因
nextInt(10) 不能直接把 next(31) 的结果对 10 取模,因为 2 31 2^{31} 2 31
2 31 = 10 × 214748364 + 8. 2^{31}=10\times214748364+8. 2 31 = 10 × 214748364 + 8. 在 0 , … , 2 31 − 1 0,\ldots,2^{31}-1 0 , … , 2 31 − 1 214748365 214748365 214748365 214748364 214748364 214748364 官方文档中 nextInt 的拒绝采样 。
因此,前面代码中的溢出检查,等价于判断 q q q
q ∈ [ 2147483640 , 2147483647 ] = [ 2 31 − 8 , 2 31 − 1 ] . q\in[2147483640,2147483647]=[2^{31}-8,2^{31}-1]. q ∈ [ 2147483640 , 2147483647 ] = [ 2 31 − 8 , 2 31 − 1 ] . 接受区间 [ 0 , 2147483639 ] [0,2147483639] [ 0 , 2147483639 ]
随机数重试的次数
一般的 nextInt(bound) 可能连续拒绝,但对于 bound = 10,连续两次拒绝不可能发生 ,这可以通过计算状态的下一状态来验证。
令 M = 2 48 M=2^{48} M = 2 48 q = v ≫ 17 q=v\gg17 q = v ≫ 17
v ∈ [ M − 8 ⋅ 2 17 , M − 1 ] = [ M − 2 20 , M − 1 ] . v\in[M-8\cdot2^{17},M-1]=[M-2^{20},M-1]. v ∈ [ M − 8 ⋅ 2 17 , M − 1 ] = [ M − 2 20 , M − 1 ] . 这个区间只有 2 20 = 1 , 048 , 576 2^{20}=1,048,576 2 20 = 1 , 048 , 576 v ′ = ( A v + 11 ) m o d M v'=(Av+11)\bmod M v ′ = ( A v + 11 ) mod M
A = 0x5DEECE66D M = 1 << 48 reject_start = M - ( 1 << 20 ) max_next = max ( ( A * v + 11 ) % M for v in range ( reject_start , M ) ) assert max_next == 281474868936375 assert max_next < reject_start 也就是说,重抽得到的 q ′ = v ′ ≫ 17 q'=v'\gg17 q ′ = v ′ ≫ 17 2147482825 2147482825 2147482825 2147483640 2147483640 2147483640 nextInt(10) 最多生成两个 31 位数:首次生成,加上至多一次重试。实现时可以把重试循环改成一次条件分支。
触发重试的概率
固定区块坐标,让世界种子的低 48 位均匀取值。加上坐标项、与常量 XOR 都是一一映射;由于 A A A u ↦ ( A u + 11 ) m o d 2 48 u\mapsto(Au+11)\bmod2^{48} u ↦ ( A u + 11 ) mod 2 48 v v v q = v ≫ 17 q=v\gg17 q = v ≫ 17
P ( 重试 ) = 8 2 31 = 2 − 28 ≈ 3.72529 × 1 0 − 9 . P(\text{重试})=\frac{8}{2^{31}}=2^{-28}
\approx3.72529\times10^{-9}. P ( 重试 ) = 2 31 8 = 2 − 28 ≈ 3.72529 × 1 0 − 9 . 也就是平均每 268,435,456 次区块判定触发一次。概率虽小,精确搜索仍需处理这一分支:例如首次 q = 2147483640 q=2147483640 q = 2147483640
本文后续算法的局限性
在后续的数学性质分析中,我们只考虑首次输出的情况。这会造成两种情况:
误报(false positive) :首次输出落入拒绝区间,且能被 10 整除,但重抽结果不能被 10 整除。只检查首次输出会将它误判为史莱姆区块。
这个问题很容易解决:在搜索到候选后,用完整的算法验证一次,即可排除误判。
漏报(false negative) :首次输出落入拒绝区间,且不能被 10 整除,但重抽结果能被 10 整除。只检查首次输出会漏掉这个史莱姆区块。
这个问题很难解决:要考虑重抽的情况,必须在搜索算法里增加一个判断和分支,这会显著降低算法的性能。
不过考虑到概率极小,漏掉的史莱姆区块数量很少。后文的算法都是基于首次输出的情况,辅以完整验证来排除误报。
世界种子的 48 位等价关系
我们回顾一下史莱姆公式。对单个区块 ( x , z ) (x,z) ( x , z )
u = ( ( w + T ( x , z ) ) x o r C ) m o d 2 48 , u=((w+T(x,z))\mathbin{\mathrm{xor}}C)\bmod2^{48}, u = (( w + T ( x , z )) xor C ) mod 2 48 , v = ( A u + 11 ) m o d 2 48 , v=(Au+11)\bmod2^{48}, v = ( A u + 11 ) mod 2 48 , q = v ≫ 17. q=v\gg17. q = v ≫ 17. 可以看到,Random 初始化只保留低 48 位。世界种子相差 2 48 2^{48} 2 48 w ∈ [ 0 , 2 48 ) w\in[0,2^{48}) w ∈ [ 0 , 2 48 ) w w w 2 16 2^{16} 2 16
反推种子算法
在固定坐标的情况下,要想寻找到满足条件的世界种子,最直接的办法是枚举所有可能的 w w w q q q
然而,种子的取值范围很大,直接枚举所有可能的种子效率很低。我们可以利用数学性质,先缩小搜索范围,再反推世界种子。
有效种子归一化和拆分
从有效种子反推世界种子
在史莱姆公式中,世界种子与坐标项总是以 w + T ( x , z ) w+T(x,z) w + T ( x , z ) 有效种子 :
s = ( w + T ( x , z ) ) m o d 2 48 . s=(w+T(x,z))\bmod2^{48}. s = ( w + T ( x , z )) mod 2 48 . 于是初始化状态可以直接写成:
u = ( s x o r C ) m o d 2 48 . u=(s\mathbin{\mathrm{xor}}C)\bmod2^{48}. u = ( s xor C ) mod 2 48 . 对固定坐标,T ( x , z ) T(x,z) T ( x , z ) s s s
w = ( s − T ( x , z ) ) m o d 2 48 . w=(s-T(x,z))\bmod2^{48}. w = ( s − T ( x , z )) mod 2 48 . 从单个区块扩展到窗口
现在考虑一个窗口,要求其中各格都是史莱姆区块。选一格作为锚点,编号为 0,坐标记为 ( x , z ) (x,z) ( x , z ) s s s ( α i , β i ) (\alpha_i,\beta_i) ( α i , β i ) i i i ( x + α i , z + β i ) (x+\alpha_i,z+\beta_i) ( x + α i , z + β i ) ( α 0 , β 0 ) = ( 0 , 0 ) (\alpha_0,\beta_0)=(0,0) ( α 0 , β 0 ) = ( 0 , 0 )
后续推导统一以锚点 ( 51069 , 419124 ) (51069,419124) ( 51069 , 419124 ) x = 51069 , … , 51073 x=51069,\ldots,51073 x = 51069 , … , 51073 z = 419124 , … , 419128 z=419124,\ldots,419128 z = 419124 , … , 419128 i = 5 β i + α i i=5\beta_i+\alpha_i i = 5 β i + α i α i , β i ∈ { 0 , 1 , 2 , 3 , 4 } \alpha_i,\beta_i\in\{0,1,2,3,4\} α i , β i ∈ { 0 , 1 , 2 , 3 , 4 }
z \ x z\backslash x z \ x 51069 51070 51071 51072 51073 419124 (锚点)0 1 2 3 4 419125 5 6 7 8 9 419126 10 11 12 13 14 419127 15 16 17 18 19 419128 20 21 22 23 24
窗口不一定是实心的方阵,也可以是任意的图案。下面是一个 6×6 苦力怕脸的例子。
取左上角为锚点,α \alpha α β \beta β i i i
β \ α \beta\backslash\alpha β \ α 0 1 2 3 4 5 0 0 1 · · 2 3 1 4 5 · · 6 7 2 · · 8 9 · · 3 · 10 11 12 13 · 4 · 14 15 16 17 · 5 · 18 · · 19 ·
第 i i i α i \alpha_i α i β i \beta_i β i · 处的则可以是也可以不是。若还要求 · 处都一定不是史莱姆区块,在最后验证时补查即可。由于筛选剩下的种子很少,而一个区块不是史莱姆区块的概率很高,这样的做法不会带来很大的额外开销,但却能简化搜索算法,提高搜索效率。
各格相对锚点的坐标项
窗口内各格共享同一个 w w w s s s d i d_i d i 相对坐标项 。
第 i i i T ( x + α i , z + β i ) T(x+\alpha_i,z+\beta_i) T ( x + α i , z + β i ) T i T_i T i T 0 T_0 T 0
s = ( w + T 0 ) m o d 2 48 , d i = ( T i − T 0 ) m o d 2 48 . s=(w+T_0)\bmod2^{48},\qquad d_i=(T_i-T_0)\bmod2^{48}. s = ( w + T 0 ) mod 2 48 , d i = ( T i − T 0 ) mod 2 48 . 锚点满足 d 0 = 0 d_0=0 d 0 = 0
w + T i ≡ s + d i ( m o d 2 48 ) . w+T_i\equiv s+d_i\pmod{2^{48}}. w + T i ≡ s + d i ( mod 2 48 ) . 给状态和输出也加上格子下标后,每格统一按以下公式计算:
u i = ( ( s + d i ) x o r C ) m o d 2 48 , u_i=((s+d_i)\mathbin{\mathrm{xor}}C)\bmod2^{48}, u i = (( s + d i ) xor C ) mod 2 48 , v i = ( A u i + 11 ) m o d 2 48 , q i = v i ≫ 17. v_i=(Au_i+11)\bmod2^{48},\qquad q_i=v_i\gg17. v i = ( A u i + 11 ) mod 2 48 , q i = v i ≫ 17. 搜索目标就是找到同一个 s s s
w = ( s − T 0 ) m o d 2 48 . w=(s-T_0)\bmod2^{48}. w = ( s − T 0 ) mod 2 48 . 这就是以锚点为基准的有效种子归一化 。它也让不同位置的低位条件可以按坐标类复用。
将锚点和右邻格坐标代入,得到:
T 0 = T ( 51069 , 419124 ) = − 1883366190470623 , T_0=T(51069,419124)=-1883366190470623, T 0 = T ( 51069 , 419124 ) = − 1883366190470623 , T 1 = T ( 51070 , 419124 ) = − 1883363608967202. T_1=T(51070,419124)=-1883363608967202. T 1 = T ( 51070 , 419124 ) = − 1883363608967202. 后面所有相对坐标项都从同一组 25 个 T i T_i T i
由上面的坐标项:
s = ( w − 1883366190470623 ) m o d 2 48 , s=(w-1883366190470623)\bmod2^{48}, s = ( w − 1883366190470623 ) mod 2 48 , d 0 = 0 , d 1 = T 1 − T 0 = 2581503421. d_0=0,\qquad d_1=T_1-T_0=2581503421. d 0 = 0 , d 1 = T 1 − T 0 = 2581503421. 因而右邻格统一从 s + 2581503421 s+2581503421 s + 2581503421 w w w s s s s s s
有效种子的拆分
把待求的有效种子拆成:
高 13 位 h | 中间 17 位 m | 低 18 位 p s = p + 2 18 m + 2 35 h , s=p+2^{18}m+2^{35}h, s = p + 2 18 m + 2 35 h , 0 ≤ p < 2 18 , 0 ≤ m < 2 17 , 0 ≤ h < 2 13 . 0\le p<2^{18},\quad0\le m<2^{17},\quad0\le h<2^{13}. 0 ≤ p < 2 18 , 0 ≤ m < 2 17 , 0 ≤ h < 2 13 . 低 18 位的奇偶筛选
基于输出奇偶的低 18 位筛选
一个数能被 10 整除,必须先是偶数。q i = v i ≫ 17 q_i=v_i\gg17 q i = v i ≫ 17 q i q_i q i v i v_i v i
加法、乘法和逐位 XOR 的低 18 位只依赖输入的低 18 位,高位不会反过来影响低位。因此只用 p p p
[ A ( ( p + d i ) x o r C ) + 11 ] m o d 2 18 < 2 17 . [A((p+d_i)\mathbin{\mathrm{xor}}C)+11]\bmod2^{18}<2^{17}. [ A (( p + d i ) xor C ) + 11 ] mod 2 18 < 2 17 . 小于 2 17 2^{17} 2 17 p p p
实际执行时枚举 p = 0 , 1 , … , 262143 p=0,1,\ldots,262143 p = 0 , 1 , … , 262143 p p p 低位根 。后续简称为根。
锚点 ( 51069 , 419124 ) (51069,419124) ( 51069 , 419124 ) 84 个低位根 ,约占原来 262144 个取值的 0.032%。
后面跟随其中的 p = 218767 p=218767 p = 218767 2 17 = 131072 2^{17}=131072 2 17 = 131072
坐标类周期与低位根复用
对固定窗口形状,各格的偏移 ( α i , β i ) (\alpha_i,\beta_i) ( α i , β i )
d i = F ( x + α i ) − F ( x ) + G ( z + β i ) − G ( z ) ( m o d 2 48 ) . d_i=F(x+\alpha_i)-F(x)+G(z+\beta_i)-G(z)\pmod{2^{48}}. d i = F ( x + α i ) − F ( x ) + G ( z + β i ) − G ( z ) ( mod 2 48 ) . 低位筛选只看 d i m o d 2 18 d_i\bmod2^{18} d i mod 2 18 2 18 2^{18} 2 18
d i ≡ 4987142 ( 2 x α i + α i 2 ) + 5947611 α i + 4392871 ( 2 z β i + β i 2 ) + 389711 β i ( m o d 2 18 ) . \begin{aligned}
d_i\equiv{}&4987142(2x\alpha_i+\alpha_i^2)+5947611\alpha_i\\
&+4392871(2z\beta_i+\beta_i^2)+389711\beta_i\pmod{2^{18}}.
\end{aligned} d i ≡ 4987142 ( 2 x α i + α i 2 ) + 5947611 α i + 4392871 ( 2 z β i + β i 2 ) + 389711 β i ( mod 2 18 ) . 将锚点 X 增加 2 16 = 65536 2^{16}=65536 2 16 = 65536
2 ⋅ 4987142 ⋅ 2 16 α i . 2\cdot4987142\cdot2^{16}\alpha_i. 2 ⋅ 4987142 ⋅ 2 16 α i . 4987142 是偶数,所以变化是 2 18 2^{18} 2 18 2 17 = 131072 2^{17}=131072 2 17 = 131072
2 ⋅ 4392871 ⋅ 2 17 β i , 2\cdot4392871\cdot2^{17}\beta_i, 2 ⋅ 4392871 ⋅ 2 17 β i , 也必然是 2 18 2^{18} 2 18
( x m o d 65536 , z m o d 131072 ) (x\bmod65536,\ z\bmod131072) ( x mod 65536 , z mod 131072 ) 作为坐标类。同类位置所有 d i d_i d i 有效种子的完整低位根列表也相同 。
程序为每个未缓存的类筛一次根。后续筛选具体位置时,若该坐标类没有低位根,就跳过该位置;否则生成后续任务。
中间 17 位的枚举
上一步保证首次输出都是偶数,还没有保证能被 5 整除。
这里我们继续进行一次拆分,记:
ℓ = p + 2 18 m , s = ℓ + 2 35 h . \ell=p+2^{18}m,\qquad s=\ell+2^{35}h. ℓ = p + 2 18 m , s = ℓ + 2 35 h . 每根仍有 2 17 = 131072 2^{17}=131072 2 17 = 131072 m m m
每根补上全部中间位后,一共需要考虑:
84 × 131072 = 11010048 84\times131072=11010048 84 × 131072 = 11010048 种低 35 位取值。
利用输出差筛选低 35 位
高 13 位引起的输出共同平移
上一节之所以选择在第 35 位拆分,是因为 C < 2 35 C<2^{35} C < 2 35
因此我们可以固定低 35 位 ℓ = p + 2 18 m \ell=p+2^{18}m ℓ = p + 2 18 m h h h u i ( h ) u_i(h) u i ( h ) v i ( h ) v_i(h) v i ( h ) q i ( h ) q_i(h) q i ( h ) h h h
由于 XOR 不动这段高位,初始化状态满足:
u i ( h ) = ( u i ( 0 ) + 2 35 h ) m o d 2 48 . u_i(h)=(u_i(0)+2^{35}h)\bmod2^{48}. u i ( h ) = ( u i ( 0 ) + 2 35 h ) mod 2 48 . 乘 A A A
v i ( h ) = ( A u i ( h ) + 11 ) m o d 2 48 = ( A u i ( 0 ) + A h 2 35 + 11 ) m o d 2 48 . = ( ( A u i ( 0 ) + 11 ) + A h 2 35 ) m o d 2 48 . = ( v i ( 0 ) + A h 2 35 ) m o d 2 48 . \begin{aligned}
v_i(h)
&=(Au_i(h)+11)\bmod2^{48}\\
&=(Au_i(0)+Ah\,2^{35}+11)\bmod2^{48}.\\
&=((Au_i(0)+11)+Ah\,2^{35})\bmod2^{48}.\\
&=(v_i(0)+Ah\,2^{35})\bmod2^{48}.
\end{aligned} v i ( h ) = ( A u i ( h ) + 11 ) mod 2 48 = ( A u i ( 0 ) + A h 2 35 + 11 ) mod 2 48 . = (( A u i ( 0 ) + 11 ) + A h 2 35 ) mod 2 48 . = ( v i ( 0 ) + A h 2 35 ) mod 2 48 . 新增量是 2 35 2^{35} 2 35
q i ( h ) = v i ( h ) ≫ 17 = ( q i ( 0 ) + A h 2 18 ) m o d 2 31 . q_i(h)=v_i(h)\gg 17=(q_i(0)+Ah\,2^{18})\bmod2^{31}. q i ( h ) = v i ( h ) ≫ 17 = ( q i ( 0 ) + A h 2 18 ) mod 2 31 . 为方便起见,记 q ˉ i = q i ( 0 ) \bar q_i=q_i(0) q ˉ i = q i ( 0 ) q i ( h ) = ( q ˉ i + A h 2 18 ) m o d 2 31 . q_i(h)=(\bar q_i+Ah\,2^{18})\bmod2^{31}. q i ( h ) = ( q ˉ i + A h 2 18 ) mod 2 31 .
改变 h h h 2 31 2^{31} 2 31 A h 2 18 Ah\,2^{18} A h 2 18 共同平移 。
后面会筛出 p = 218767 , m = 40302 p=218767,m=40302 p = 218767 , m = 40302 q ˉ 0 = 227860608 \bar q_0=227860608 q ˉ 0 = 227860608 q ˉ 1 = 1920935636 \bar q_1=1920935636 q ˉ 1 = 1920935636 h = 2995 h=2995 h = 2995
A h 2 18 m o d 2 31 = 886833152. Ah\,2^{18}\bmod2^{31}=886833152. A h 2 18 mod 2 31 = 886833152. 因而 q 0 ( h ) = 1114693760 q_0(h)=1114693760 q 0 ( h ) = 1114693760 q 1 ( h ) = ( 1920935636 + 886833152 ) m o d 2 31 = 660285140 q_1(h)=(1920935636+886833152)\bmod2^{31}=660285140 q 1 ( h ) = ( 1920935636 + 886833152 ) mod 2 31 = 660285140
基于输出差的低 35 位过滤
各格的输出含有相同的增量,因此可以通过作差消去 h h h
δ i = ( q ˉ i − q ˉ 0 ) m o d 2 31 . \delta_i=(\bar q_i-\bar q_0)\bmod2^{31}. δ i = ( q ˉ i − q ˉ 0 ) mod 2 31 . 如果存在某个高位 h h h 2 31 2^{31} 2 31
2 31 m o d 10 = 8. 2^{31}\bmod10=8. 2 31 mod 10 = 8. 所以必要条件是:
δ i m o d 10 ∈ { 0 , 8 } . \delta_i\bmod10\in\{0,8\}. δ i mod 10 ∈ { 0 , 8 } . 沿用上一节的 p , m , h p,m,h p , m , h
q 1 − q 0 = 660285140 − 1114693760 = − 454408620. q_1-q_0=660285140-1114693760=-454408620. q 1 − q 0 = 660285140 − 1114693760 = − 454408620. 加上 2 31 2^{31} 2 31 δ 1 = 1693075028 \delta_1=1693075028 δ 1 = 1693075028 454408620 454408620 454408620
用基准输出计算也得到 ( 1920935636 − 227860608 ) m o d 2 31 = 1693075028 (1920935636-227860608)\bmod2^{31}=1693075028 ( 1920935636 − 227860608 ) mod 2 31 = 1693075028 h h h
模差的余数不属于 { 0 , 8 } \{0,8\} { 0 , 8 } 当前低 35 位无论怎样补高位都不会成功 。
锚点 ( 51069 , 419124 ) (51069,419124) ( 51069 , 419124 ) 36 种通过全部输出差条件 。
预计算与中间位无关的项
上述筛选方法需要遍历低 35 位,计算 q ˉ i \bar q_i q ˉ i
固定位置和根 p p p
σ i = p + d i , ρ i = σ i m o d 2 18 , μ i = ⌊ σ i / 2 18 ⌋ . \sigma_i=p+d_i,\qquad \rho_i=\sigma_i\bmod2^{18},\qquad \mu_i=\lfloor \sigma_i/2^{18}\rfloor. σ i = p + d i , ρ i = σ i mod 2 18 , μ i = ⌊ σ i / 2 18 ⌋ . 加入中间位后,输入就是:
ℓ + d i = ρ i + 2 18 ( μ i + m ) . \ell+d_i=\rho_i+2^{18}(\mu_i+m). ℓ + d i = ρ i + 2 18 ( μ i + m ) . 令 E = C ≫ 18 = 0 x 1790 d E=C\gg18=\mathtt{0x1790d} E = C ≫ 18 = 0x1790d
( ℓ + d i ) x o r C = ( ρ i x o r ( C m o d 2 18 ) ) + 2 18 ( ( μ i + m ) x o r E ) . (\ell+d_i)\mathbin{\mathrm{xor}}C
=(\rho_i\mathbin{\mathrm{xor}}(C\bmod2^{18}))
+2^{18}((\mu_i+m)\mathbin{\mathrm{xor}}E). ( ℓ + d i ) xor C = ( ρ i xor ( C mod 2 18 )) + 2 18 (( μ i + m ) xor E ) . 把低位推进带来的贡献记为:
κ i = ⌊ A ( ρ i x o r ( C m o d 2 18 ) ) + 11 2 17 ⌋ . \kappa_i=\left\lfloor\frac{A(\rho_i\mathbin{\mathrm{xor}}(C\bmod2^{18}))+11}{2^{17}}\right\rfloor. κ i = ⌊ 2 17 A ( ρ i xor ( C mod 2 18 )) + 11 ⌋ . 于是首次输出精确等于:
q ˉ i ( m ) = [ κ i + 2 A ( ( μ i + m ) x o r E ) ] m o d 2 31 . \bar q_i(m)=[\kappa_i+2A((\mu_i+m)\mathbin{\mathrm{xor}}E)]\bmod2^{31}. q ˉ i ( m ) = [ κ i + 2 A (( μ i + m ) xor E )] mod 2 31 . μ i , κ i \mu_i,\kappa_i μ i , κ i m m m (位置, 根) 只需准备一次。它们被称为公共项 。
应用案例:为根
p = 218767 p=218767 p = 218767 准备公共项
前两格的值为:
格子 i i i d i d_i d i ρ i \rho_i ρ i μ i \mu_i μ i κ i \kappa_i κ i 0 0 218767 0 46624833586 1 2581503421 128076 9848 13419656886
这些值算一次即可用于这个根的全部中间位。代入 m = 40302 m=40302 m = 40302 ( 40302 x o r 96525 ) = 124003 (40302\mathbin{\mathrm{xor}}96525)=124003 ( 40302 xor 96525 ) = 124003 ( ( 9848 + 40302 ) x o r 96525 ) = 113387 ((9848+40302)\mathbin{\mathrm{xor}}96525)=113387 (( 9848 + 40302 ) xor 96525 ) = 113387
q ˉ 0 = [ 46624833586 + 2 A × 124003 ] m o d 2 31 = 227860608 , \bar q_0=[46624833586+2A\times124003]\bmod2^{31}=227860608, q ˉ 0 = [ 46624833586 + 2 A × 124003 ] mod 2 31 = 227860608 , q ˉ 1 = [ 13419656886 + 2 A × 113387 ] m o d 2 31 = 1920935636. \bar q_1=[13419656886+2A\times113387]\bmod2^{31}=1920935636. q ˉ 1 = [ 13419656886 + 2 A × 113387 ] mod 2 31 = 1920935636. κ i \kappa_i κ i 2 31 2^{31} 2 31 q ˉ i \bar q_i q ˉ i
中间位的成组筛选
上一节的预计算可以加快单个输出的计算,但如果逐个检查,仍需对每个 m m m
将中间位分成每组 16 个候选后,利用 XOR 常量中的连续零位,每格只需计算组首、组尾的模输出差,就能判断整组候选是否满足该格的输出差条件。将各格的允许掩码按位 AND,得到通过整个窗口筛选的候选。
中间位分组规则
预计算后的输出公式为:
q ˉ i ( m ) = [ κ i + 2 A ( ( μ i + m ) x o r E ) ] m o d 2 31 . \bar q_i(m)=[\kappa_i+2A((\mu_i+m)\mathbin{\mathrm{xor}}E)]\bmod2^{31}. q ˉ i ( m ) = [ κ i + 2 A (( μ i + m ) xor E )] mod 2 31 . 其中 μ i , κ i \mu_i,\kappa_i μ i , κ i ( μ i + m ) x o r E (\mu_i+m)\mathbin{\mathrm{xor}}E ( μ i + m ) xor E E = 0 x 1790 d E=\mathtt{0x1790d} E = 0x1790d m m m
m j = b a s e + 16 j , j = 0 , … , 15. m_j=\mathrm{base}+16j,\qquad j=0,\ldots,15. m j = base + 16 j , j = 0 , … , 15. b a s e \mathrm{base} base 2 4 × 2 9 = 8192 2^4\times2^9=8192 2 4 × 2 9 = 8192 2 17 2^{17} 2 17 g g g
b a s e = 256 ⌊ g / 16 ⌋ + ( g m o d 16 ) , g = 0 , … , 8191. \mathrm{base}=256\lfloor g/16\rfloor+(g\bmod16),\qquad g=0,\ldots,8191. base = 256 ⌊ g /16 ⌋ + ( g mod 16 ) , g = 0 , … , 8191. 应用案例:包含
m = 40302 m=40302 m = 40302 的那一组
固定根仍为 p = 218767 p=218767 p = 218767 g = 2526 g=2526 g = 2526 b a s e = 40206 \mathrm{base}=40206 base = 40206
m j = 40206 + 16 j = 40206 , 40222 , … , 40446. m_j=40206+16j=40206,40222,\ldots,40446. m j = 40206 + 16 j = 40206 , 40222 , … , 40446. 其中 j = 6 j=6 j = 6 m = 40302 m=40302 m = 40302
组内输出差的分段常量性质
对当前这一组,记第 i i i
γ i = μ i + b a s e . \gamma_i=\mu_i+\mathrm{base}. γ i = μ i + base . 该格的 XOR 输入便是 γ i + 16 j \gamma_i+16j γ i + 16 j d 0 = 0 d_0=0 d 0 = 0 0 ≤ p < 2 18 0\le p<2^{18} 0 ≤ p < 2 18 μ 0 = 0 \mu_0=0 μ 0 = 0 γ 0 = b a s e \gamma_0=\mathrm{base} γ 0 = base
δ i ( m j ) = [ κ i − κ 0 + 2 A ( ( ( γ i + 16 j ) x o r E ) − ( ( γ 0 + 16 j ) x o r E ) ) ] m o d 2 31 . \delta_i(m_j)=\left[\kappa_i-\kappa_0
+2A\left(((\gamma_i+16j)\mathbin{\mathrm{xor}}E)
-((\gamma_0+16j)\mathbin{\mathrm{xor}}E)\right)\right]\bmod2^{31}. δ i ( m j ) = [ κ i − κ 0 + 2 A ( (( γ i + 16 j ) xor E ) − (( γ 0 + 16 j ) xor E ) ) ] mod 2 31 . 这里 κ i − κ 0 \kappa_i-\kappa_0 κ i − κ 0
输入 γ i + 16 j \gamma_i+16j γ i + 16 j [ 256 k , 256 ( k + 1 ) ) [256k,256(k+1)) [ 256 k , 256 ( k + 1 )) E E E
( ( γ i + 16 ( j + 1 ) ) x o r E ) = ( ( γ i + 16 j ) x o r E ) + 16. ((\gamma_i+16(j+1))\mathbin{\mathrm{xor}}E)
=((\gamma_i+16j)\mathbin{\mathrm{xor}}E)+16. (( γ i + 16 ( j + 1 )) xor E ) = (( γ i + 16 j ) xor E ) + 16. 跨到下一个区间的那一步则不同:由于 256 = 2 8 256=2^8 256 = 2 8 E E E
一组输入的总跨度是 16 × 15 = 240 < 256 16\times15=240<256 16 × 15 = 240 < 256
锚点的 γ 0 = b a s e \gamma_0=\mathrm{base} γ 0 = base i i i 每格的模输出差至多有前后两个值,每段内保持不变 。没有跨界时,整组共用一个值;不同格子的分界位置由各自的 γ i \gamma_i γ i
仍用 b a s e = 40206 \mathrm{base}=40206 base = 40206 μ 1 = 9848 \mu_1=9848 μ 1 = 9848 γ 1 = 50054 \gamma_1=50054 γ 1 = 50054 γ 0 = 40206 \gamma_0=40206 γ 0 = 40206 E = 96525 E=96525 E = 96525
j j j m j = γ 0 + 16 j m_j=\gamma_0+16j m j = γ 0 + 16 j γ 1 + 16 j \gamma_1+16j γ 1 + 16 j 锚点 XOR 后 右邻格 XOR 后 XOR 后两输入之差 0 40206 50054 123907 113291 −10616 1 40222 50070 123923 113307 −10616 7 40318 50166 124019 113403 −10616 8 40334 50182 124035 113931 −10104 15 40446 50294 124147 114043 −10104
j = 0 , … , 7 j=0,\ldots,7 j = 0 , … , 7 − 10616 -10616 − 10616 j = 7 j=7 j = 7 50176 50176 50176 − 10104 -10104 − 10104
表格最后一列仍是输入差。代入输出公式,才得到真正要筛选的模输出差:
δ 1 ( m j ) = { ( 13419656886 − 46624833586 − 2 A × 10616 ) m o d 2 31 = 1693075028 , j = 0 , … , 7 , ( 13419656886 − 46624833586 − 2 A × 10104 ) m o d 2 31 = 411302484 , j = 8 , … , 15. \delta_1(m_j)=\begin{cases}
(13419656886-46624833586-2A\times10616)\bmod2^{31}=1693075028,&j=0,\ldots,7,\\
(13419656886-46624833586-2A\times10104)\bmod2^{31}=411302484,&j=8,\ldots,15.
\end{cases} δ 1 ( m j ) = { ( 13419656886 − 46624833586 − 2 A × 10616 ) mod 2 31 = 1693075028 , ( 13419656886 − 46624833586 − 2 A × 10104 ) mod 2 31 = 411302484 , j = 0 , … , 7 , j = 8 , … , 15. 前段除以 10 余 8,通过;后段余 4,淘汰。仅检查右邻格,就能一次保留前 8 个、排除后 8 个中间位。
16 位掩码的构造与求交
每格至多有两段,所以组首 j = 0 j=0 j = 0 j = 15 j=15 j = 15 δ i ( m j ) m o d 10 ∈ { 0 , 8 } \delta_i(m_j)\bmod10\in\{0,8\} δ i ( m j ) mod 10 ∈ { 0 , 8 }
组首输入在当前 256 区间内的偏移为 o f f s e t i = γ i m o d 256 \mathrm{offset}_i=\gamma_i\bmod256 offset i = γ i mod 256 256 − o f f s e t i 256-\mathrm{offset}_i 256 − offset i
c u t i = ⌈ 256 − o f f s e t i 16 ⌉ . \mathrm{cut}_i=\left\lceil\frac{256-\mathrm{offset}_i}{16}\right\rceil. cut i = ⌈ 16 256 − offset i ⌉ . c u t i \mathrm{cut}_i cut i j < c u t i j<\mathrm{cut}_i j < cut i j ≥ c u t i j\ge \mathrm{cut}_i j ≥ cut i c u t i = 16 \mathrm{cut}_i=16 cut i = 16 j = 16 j=16 j = 16
程序用一个 16 位 m a s k \mathrm{mask} mask j j j m j m_j m j c u t i \mathrm{cut}_i cut i
f r o n t i = 2 c u t i − 1 , b a c k i = 0 x f f f f x o r f r o n t i . \mathrm{front}_i=2^{\mathrm{cut}_i}-1,\qquad
\mathrm{back}_i=\mathtt{0xffff}\mathbin{\mathrm{xor}}\mathrm{front}_i. front i = 2 cut i − 1 , back i = 0xffff xor front i . 检查组首、组尾的模输出差:前段满足条件,就把 f r o n t i \mathrm{front}_i front i b a c k i \mathrm{back}_i back i 0xffff,都不满足时为 0。c u t i = 16 \mathrm{cut}_i=16 cut i = 16
累计 m a s k \mathrm{mask} mask 0xffff 开始,与各非锚点格子的允许掩码逐个按位 AND;变成 0 就整组退出。锚点与自身的模输出差恒为 0,无需单独检查。
右邻格允许 j = 0 , … , 7 j=0,\ldots,7 j = 0 , … , 7 0x00ff。继续检查窗口内各格,挑出会进一步缩小结果的几步:
检查的格子 该格允许的 j j j 该格掩码 累计交集 i = 1 i=1 i = 1 0~7 0x00ff0~7 i = 3 i=3 i = 3 2~15 0xfffc2~7 i = 4 i=4 i = 4 3~15 0xfff83~7 i = 8 i=8 i = 8 4~15 0xfff04~7 i = 9 i=9 i = 9 6~15 0xffc06、7
表中略去的格子也都参与检查,但没有继续缩小累计交集。检查完全部 25 格,最终 m a s k \mathrm{mask} mask 0x00c0,只剩 m 6 = 40302 m_6=40302 m 6 = 40302 m 7 = 40318 m_7=40318 m 7 = 40318
m a s k \mathrm{mask} mask
高 13 位的区间求解
对组筛选留下的一个 m m m ℓ = p + 2 18 m \ell=p+2^{18}m ℓ = p + 2 18 m h = 0 h=0 h = 0
q ˉ i = r i + 2 18 b i , 0 ≤ r i < 2 18 , 0 ≤ b i < 8192. \bar q_i=r_i+2^{18}b_i,\qquad 0\le r_i<2^{18},\quad0\le b_i<8192. q ˉ i = r i + 2 18 b i , 0 ≤ r i < 2 18 , 0 ≤ b i < 8192. r i r_i r i b i b_i b i
q i ( h ) = r i + 2 18 [ ( b i + A h ) m o d 8192 ] . q_i(h)=r_i+2^{18}[(b_i+Ah)\bmod8192]. q i ( h ) = r i + 2 18 [( b i + A h ) mod 8192 ] . 高位换元与模逆恢复
令:
θ = A h m o d 8192. \theta=Ah\bmod8192. θ = A h mod 8192. A A A 8192 = 2 13 8192=2^{13} 8192 = 2 13
A m o d 8192 = 1645 , 1645 × 4965 ≡ 1 ( m o d 8192 ) . A\bmod8192=1645,\qquad1645\times4965\equiv1\pmod{8192}. A mod 8192 = 1645 , 1645 × 4965 ≡ 1 ( mod 8192 ) . 因此求到 θ \theta θ
h = 4965 θ m o d 8192. h=4965\theta\bmod8192. h = 4965 θ mod 8192. 单格的区间与同余条件
记 ϕ i = ( b i + θ ) m o d 8192 \phi_i=(b_i+\theta)\bmod8192 ϕ i = ( b i + θ ) mod 8192 r i r_i r i 2 18 ≡ − 1 ( m o d 5 ) 2^{18}\equiv-1\pmod5 2 18 ≡ − 1 ( mod 5 )
q i = r i + 2 18 ϕ i ≡ r i − ϕ i ( m o d 5 ) . q_i=r_i+2^{18}\phi_i\equiv r_i-\phi_i\pmod5. q i = r i + 2 18 ϕ i ≡ r i − ϕ i ( mod 5 ) . 所以要 ϕ i ≡ r i ( m o d 5 ) \phi_i\equiv r_i\pmod5 ϕ i ≡ r i ( mod 5 ) b i + θ b_i+\theta b i + θ τ i = 8192 − b i \tau_i=8192-b_i τ i = 8192 − b i b i = 0 b_i=0 b i = 0
θ \theta θ ϕ i \phi_i ϕ i ϕ i ≡ r i ( m o d 5 ) \phi_i\equiv r_i\pmod5 ϕ i ≡ r i ( mod 5 ) [ 0 , τ i ) [0,\tau_i) [ 0 , τ i ) b i + θ b_i+\theta b i + θ θ ≡ r i − b i ( m o d 5 ) \theta\equiv r_i-b_i\pmod5 θ ≡ r i − b i ( mod 5 ) [ τ i , 8192 ) [\tau_i,8192) [ τ i , 8192 ) b i + θ − 8192 b_i+\theta-8192 b i + θ − 8192 θ ≡ r i − b i + 2 ( m o d 5 ) \theta\equiv r_i-b_i+2\pmod5 θ ≡ r i − b i + 2 ( mod 5 )
多格条件的区间求交
将 θ \theta θ η ∈ { 0 , 1 , 2 , 3 , 4 } \eta\in\{0,1,2,3,4\} η ∈ { 0 , 1 , 2 , 3 , 4 }
( I i , 0 , I i , 1 , I i , 2 , I i , 3 , I i , 4 ) . (I_{i,0},I_{i,1},I_{i,2},I_{i,3},I_{i,4}). ( I i , 0 , I i , 1 , I i , 2 , I i , 3 , I i , 4 ) . 其中 I i , η I_{i,\eta} I i , η i i i η \eta η
I i , η = { [ 0 , τ i ) , η = ( r i − b i ) m o d 5 , [ τ i , 8192 ) , η = ( r i − b i + 2 ) m o d 5 , ∅ , 其余情况 . I_{i,\eta}=\begin{cases}
[0,\tau_i),&\eta=(r_i-b_i)\bmod5,\\
[\tau_i,8192),&\eta=(r_i-b_i+2)\bmod5,\\
\varnothing,&\text{其余情况}.
\end{cases} I i , η = ⎩ ⎨ ⎧ [ 0 , τ i ) , [ τ i , 8192 ) , ∅ , η = ( r i − b i ) mod 5 , η = ( r i − b i + 2 ) mod 5 , 其余情况 . 前后两段要求的余数相差 2,因此分别填入五元组中的两项,其余三项为空集。同一个 θ \theta θ
I η = ⋂ i I i , η , η = 0 , 1 , 2 , 3 , 4. I_\eta=\bigcap_i I_{i,\eta},\qquad \eta=0,1,2,3,4. I η = i ⋂ I i , η , η = 0 , 1 , 2 , 3 , 4. 逐格计算时,至多有两项非空;当进行到五项全部为空时,便可提前结束当前低 35 位的搜索。
检查完所有格子后,对每个非空的 I η = [ l o , h i ) I_\eta=[\mathrm{lo},\mathrm{hi}) I η = [ lo , hi ) η \eta η
θ min = l o + ( ( η − l o ) m o d 5 ) . \theta_{\min}=\mathrm{lo}+((\eta-\mathrm{lo})\bmod5). θ m i n = lo + (( η − lo ) mod 5 ) . 若 θ min ≥ h i \theta_{\min}\ge\mathrm{hi} θ m i n ≥ hi θ \theta θ θ \theta θ
θ = θ min + 5 k < h i , k = 0 , 1 , 2 , … \theta=\theta_{\min}+5k<\mathrm{hi},\quad k=0,1,2,\ldots θ = θ m i n + 5 k < hi , k = 0 , 1 , 2 , … 并求出 h = 4965 θ m o d 8192 h=4965\theta\bmod8192 h = 4965 θ mod 8192
应用案例:从
m = 40302 m=40302 m = 40302 求出高位
固定 p = 218767 , m = 40302 p=218767,m=40302 p = 218767 , m = 40302
格子 q ˉ i \bar q_i q ˉ i r i r_i r i b i b_i b i 取模分界点 τ i \tau_i τ i 0 227860608 57472 869 7323 1 1920935636 206548 7327 865
代入单格条件,锚点要求:[ 0 , 7323 ) [0,7323) [ 0 , 7323 ) θ m o d 5 = 3 \theta\bmod5=3 θ mod 5 = 3 [ 7323 , 8192 ) [7323,8192) [ 7323 , 8192 ) θ m o d 5 = 0 \theta\bmod5=0 θ mod 5 = 0 [ 0 , 865 ) [0,865) [ 0 , 865 ) θ m o d 5 = 1 \theta\bmod5=1 θ mod 5 = 1 [ 865 , 8192 ) [865,8192) [ 865 , 8192 ) θ m o d 5 = 3 \theta\bmod5=3 θ mod 5 = 3
只有余数相同的两段能求交,因此前两格共同留下 [ 865 , 7323 ) [865,7323) [ 865 , 7323 )
已检查到的格子 当前保留区间 θ m o d 5 \theta\bmod5 θ mod 5 i = 1 i=1 i = 1 [ 865 , 7323 ) [865,7323) [ 865 , 7323 ) 3 i = 2 i=2 i = 2 [ 865 , 3544 ) [865,3544) [ 865 , 3544 ) 3 i = 3 i=3 i = 3 [ 3202 , 3544 ) [3202,3544) [ 3202 , 3544 ) 3 i = 13 i=13 i = 13 [ 3202 , 3506 ) [3202,3506) [ 3202 , 3506 ) 3 i = 19 i=19 i = 19 [ 3382 , 3506 ) [3382,3506) [ 3382 , 3506 ) 3 i = 22 i=22 i = 22 [ 3382 , 3440 ) [3382,3440) [ 3382 , 3440 ) 3 全部 25 格 [ 3382 , 3440 ) [3382,3440) [ 3382 , 3440 ) 3
第一个同余解为 θ min = 3382 + ( ( 3 − 3382 ) m o d 5 ) = 3383 \theta_{\min}=3382+((3-3382)\bmod5)=3383 θ m i n = 3382 + (( 3 − 3382 ) mod 5 ) = 3383
θ = 3383 , 3388 , … , 3438. \theta=3383,3388,\ldots,3438. θ = 3383 , 3388 , … , 3438. 取第一个 θ = 3383 \theta=3383 θ = 3383
h = 4965 × 3383 m o d 8192 = 2995 , h=4965\times3383\bmod8192=2995, h = 4965 × 3383 mod 8192 = 2995 , s = 218767 + 2 18 × 40302 + 2 35 × 2995 = 102917981558415 , s=218767+2^{18}\times40302+2^{35}\times2995=102917981558415, s = 218767 + 2 18 × 40302 + 2 35 × 2995 = 102917981558415 , w = ( s − T 0 ) m o d 2 48 = 15959335054446. w=(s-T_0)\bmod2^{48}=15959335054446. w = ( s − T 0 ) mod 2 48 = 15959335054446. 前两格此时 ϕ 0 = 4252 \phi_0=4252 ϕ 0 = 4252 ϕ 1 = 2518 \phi_1=2518 ϕ 1 = 2518 q 0 = 1114693760 q_0=1114693760 q 0 = 1114693760 q 1 = 660285140 q_1=660285140 q 1 = 660285140
种子恢复与验证
求出高位 h h h
s = p + 2 18 m + 2 35 h . s=p+2^{18}m+2^{35}h. s = p + 2 18 m + 2 35 h . 用 s + d i s+d_i s + d i i i i
w = ( s − T 0 ) m o d 2 48 . w=(s-T_0)\bmod2^{48}. w = ( s − T 0 ) mod 2 48 . 前面的筛选只考虑首次输出。完整验证可以排除重试后失败的候选,却无法找回筛选时已经漏掉的解。因此,算法保证结果正确,但不保证找齐所有解 。
将刚恢复的 w = 15959335054446 w=15959335054446 w = 15959335054446 q i q_i q i
z \ x z\backslash x z \ x 51069 51070 51071 51072 51073 419124 1114693760 660285140 2105382940 47575410 1796905160 419125 2074383590 1410817530 1734889590 2009625200 440710690 419126 1664890290 537178720 1699969350 2115254790 688097620 419127 1842255790 1387847170 1302453480 1264531310 344660 419128 1757217670 204531470 2132545510 1606583470 569937090
每个数都能被 10 整除,并且都小于拒绝区间起点 2147483640 2147483640 2147483640 nextInt(10) 都返回 0。这个世界种子确实让所选窗口的 25 格全是史莱姆区块。
完整执行流程与 GPU 任务划分
实现时按以下顺序执行:
遍历给定范围内的锚点,计算所属坐标类 ( x m o d 65536 , z m o d 131072 ) (x\bmod65536,\ z\bmod131072) ( x mod 65536 , z mod 131072 )
若该类尚未缓存,筛出低 18 位根并缓存列表;同类位置直接复用。列表为空就跳过该位置。
计算该位置的完整相对项 d i d_i d i (位置, 根) 任务。
每个任务预计算 μ i , κ i \mu_i,\kappa_i μ i , κ i
将中间位分为 8192 组,用输出差条件构造 16 位 m a s k \mathrm{mask} mask m m m
对每个候选 m m m θ \theta θ h h h
拼出 s s s w w w
每个 GPU 搜索线程负责一个 (位置, 根, 中间位组),为 m a s k \mathrm{mask} mask
对锚点 ( 51069 , 419124 ) (51069,419124) ( 51069 , 419124 )
262144 个低位取值 ⟶ 84 个根 262144\text{ 个低位取值}\longrightarrow84\text{ 个根} 262144 个低位取值 ⟶ 84 个根 ⟶ 11010048 种低 35 位 ⟶ 36 个通过输出差筛选的候选 \longrightarrow11010048\text{ 种低 35 位}\longrightarrow36\text{ 个通过输出差筛选的候选} ⟶ 11010048 种低 35 位 ⟶ 36 个通过输出差筛选的候选 ⟶ 24 个世界种子的低 48 位。 \longrightarrow24\text{ 个世界种子的低 48 位。} ⟶ 24 个世界种子的低 48 位。 通过输出差筛选的 36 个低 35 位候选都对应低位根 p = 218767 p=218767 p = 218767 m = 40302 m=40302 m = 40302 40318 40318 40318
最终优化效果
正推与反推
以锚点 (51069,419124) 的实心 5×5 窗口为例,比较各版算法搜索种子的耗时。
低位筛选留下 84 个根。先枚举剩余位,再将高位枚举改为区间求解,最后依次加入输出差过滤、公共项预计算和成组筛选。与文章介绍的顺序不同,测试把区间求解提前了,后面三步便能在同一个高位求解器上比较。
下表只计搜索阶段,包含公共项预计算,不含筛根和数据传输。
版本 搜索阶段耗时 相对上一版加速 正推枚举全部低 48 位 87.86 分钟(外推) — 低 18 位筛根后,枚举剩余 30 位 1692.737 ms 3,114.14 倍(外推) 将高位枚举改为区间求解 0.780288 ms 2,169.37 倍 +输出差过滤 0.318464 ms 2.45 倍 +公共项预计算 0.264192 ms 1.21 倍 +中间位成组筛选 0.155648 ms 1.70 倍
正推实际只枚举了 2 34 2^{34} 2 34
反推时间均取中位数:剩余 30 位枚举测了五轮,后四版在同一次测试中轮换测了 21 轮。高位求解的倍率由这两次测试计算。
坐标类复用
再看多个位置之间的低位根复用。取 512 个坐标类,每类选 64 个位置,共 32,768 个位置。后续搜索都使用成组筛选和区间求解,只改变筛根和任务准备的方式。
版本 筛根次数 批次耗时 相对上一版加速 每个位置各自筛根 32,768 149.774 ms — 同类位置复用低位根 512 16.277 ms 9.20 倍 再跳过无根类的位置构造与上传 512 10.390 ms 1.57 倍
表中时间包含分类、筛根、任务展开、传输、搜索和结果回传,取五轮中位数,不含一次性初始化。三版生成的 15,424 个根任务完全相同,搜索结果也一致。
这批位置中,每类重复出现 64 次,复用能省去大量筛根。换成 4096 个不同类的散点,耗时反而从 20.631 ms 增至 22.663 ms:没有根可复用,分类就成了额外开销。
完整搜索耗时
搜索范围 锚点数 命中数 耗时中位数 文章示例 (51069,419124) 1 24 1.767 ms 原点曼哈顿半径 512 525,313 0 4.307 s
单点测了七轮,区域扫描测了五轮,每轮重新筛根。这里计入了筛根、搜索和结果回传,不含一次性的 CUDA 初始化和显存申请。
符号与常量总表
以下按推导顺序分组。各表中的取值均为整数;mod 取非负余数。
下标 i i i i = 0 i=0 i = 0
坐标与坐标项
符号 含义 定义或约定 x , z x,z x , z 区块坐标 Java 有符号 32 位整数;窗口推导中指锚点坐标 i i i 窗口内的格子编号 从 0 开始,0 为锚点 α i , β i \alpha_i,\beta_i α i , β i 第 i i i 第 i i i ( x + α i , z + β i ) (x+\alpha_i,z+\beta_i) ( x + α i , z + β i ) J 32 ( ξ ) J_{32}(\xi) J 32 ( ξ ) Java 有符号 32 位整数的溢出处理 ( ( ξ + 2 31 ) m o d 2 32 ) − 2 31 ((\xi+2^{31})\bmod2^{32})-2^{31} (( ξ + 2 31 ) mod 2 32 ) − 2 31 F ( x ) F(x) F ( x ) 坐标项的 X 轴部分 J 32 ( 4987142 x 2 ) + J 32 ( 5947611 x ) J_{32}(4987142x^2)+J_{32}(5947611x) J 32 ( 4987142 x 2 ) + J 32 ( 5947611 x ) G ( z ) G(z) G ( z ) 坐标项的 Z 轴部分 4392871 J 32 ( z 2 ) + J 32 ( 389711 z ) 4392871J_{32}(z^2)+J_{32}(389711z) 4392871 J 32 ( z 2 ) + J 32 ( 389711 z ) T ( x , z ) T(x,z) T ( x , z ) 完整坐标项 F ( x ) + G ( z ) F(x)+G(z) F ( x ) + G ( z ) T i T_i T i 第 i i i T ( x + α i , z + β i ) T(x+\alpha_i,z+\beta_i) T ( x + α i , z + β i ) d i d_i d i 第 i i i ( T i − T 0 ) m o d 2 48 (T_i-T_0)\bmod2^{48} ( T i − T 0 ) mod 2 48 d 0 = 0 d_0=0 d 0 = 0
有效种子与位数拆分
符号 含义 定义或约定 w w w 世界种子 搜索与恢复时取低 48 位,0 ≤ w < 2 48 0\le w<2^{48} 0 ≤ w < 2 48 s s s 归一化有效种子 ( w + T 0 ) m o d 2 48 (w+T_0)\bmod2^{48} ( w + T 0 ) mod 2 48 w = ( s − T 0 ) m o d 2 48 w=(s-T_0)\bmod2^{48} w = ( s − T 0 ) mod 2 48 p p p 有效种子的低 18 位 0 ≤ p < 2 18 0\le p<2^{18} 0 ≤ p < 2 18 m m m 有效种子的中间 17 位 0 ≤ m < 2 17 0\le m<2^{17} 0 ≤ m < 2 17 h h h 有效种子的高 13 位 0 ≤ h < 2 13 0\le h<2^{13} 0 ≤ h < 2 13 s = p + 2 18 m + 2 35 h s=p+2^{18}m+2^{35}h s = p + 2 18 m + 2 35 h ℓ \ell ℓ 有效种子的低 35 位 p + 2 18 m p+2^{18}m p + 2 18 m 0 ≤ ℓ < 2 35 0\le\ell<2^{35} 0 ≤ ℓ < 2 35
Random 状态与输出差
符号 含义 定义或约定 u u u 单个区块的 Random 初始化状态 ( ( w + T ( x , z ) ) x o r C ) m o d 2 48 ((w+T(x,z))\mathbin{\mathrm{xor}}C)\bmod2^{48} (( w + T ( x , z )) xor C ) mod 2 48 v v v 单个区块推进一次后的状态 ( A u + 11 ) m o d 2 48 (Au+11)\bmod2^{48} ( A u + 11 ) mod 2 48 q q q 单个区块首次生成的 31 位数 v ≫ 17 v\gg17 v ≫ 17 u i u_i u i 第 i i i ( ( s + d i ) x o r C ) m o d 2 48 ((s+d_i)\mathbin{\mathrm{xor}}C)\bmod2^{48} (( s + d i ) xor C ) mod 2 48 v i v_i v i 第 i i i ( A u i + 11 ) m o d 2 48 (Au_i+11)\bmod2^{48} ( A u i + 11 ) mod 2 48 q i q_i q i 第 i i i v i ≫ 17 v_i\gg17 v i ≫ 17 q ˉ i \bar q_i q ˉ i 第 i i i h = 0 h=0 h = 0 q i ( 0 ) q_i(0) q i ( 0 ) δ i \delta_i δ i 第 i i i ( q ˉ i − q ˉ 0 ) m o d 2 31 (\bar q_i-\bar q_0)\bmod2^{31} ( q ˉ i − q ˉ 0 ) mod 2 31
u , v , u i , v i u,v,u_i,v_i u , v , u i , v i q , q i , q ˉ i q,q_i,\bar q_i q , q i , q ˉ i
u i ( h ) u_i(h) u i ( h ) v i ( h ) v_i(h) v i ( h ) q i ( h ) q_i(h) q i ( h ) ℓ = p + 2 18 m \ell=p+2^{18}m ℓ = p + 2 18 m h h h q i ( 0 ) q_i(0) q i ( 0 ) i i i q ˉ i \bar q_i q ˉ i q ˉ i ( m ) \bar q_i(m) q ˉ i ( m ) p p p h = 0 h=0 h = 0 m m m q ˉ i \bar q_i q ˉ i m m m δ i ( m j ) \delta_i(m_j) δ i ( m j ) m = m j m=m_j m = m j ( q ˉ i ( m j ) − q ˉ 0 ( m j ) ) m o d 2 31 (\bar q_i(m_j)-\bar q_0(m_j))\bmod2^{31} ( q ˉ i ( m j ) − q ˉ 0 ( m j )) mod 2 31 p p p m j m_j m j h h h
固定位置和根后的预计算
下列各项均在位置和根 p p p m m m
符号 含义 定义或约定 σ i \sigma_i σ i 根与相对坐标项的完整整数和 p + d i p+d_i p + d i ρ i \rho_i ρ i 上述整数和的低 18 位 σ i m o d 2 18 \sigma_i\bmod2^{18} σ i mod 2 18 μ i \mu_i μ i 上述整数和除以 2 18 2^{18} 2 18 ⌊ σ i / 2 18 ⌋ \lfloor\sigma_i/2^{18}\rfloor ⌊ σ i / 2 18 ⌋ κ i \kappa_i κ i 低 18 位输入对首次输出的公共贡献 ⌊ [ A ( ρ i x o r ( C m o d 2 18 ) ) + 11 ] / 2 17 ⌋ \left\lfloor[A(\rho_i\mathbin{\mathrm{xor}}(C\bmod2^{18}))+11]/2^{17}\right\rfloor ⌊ [ A ( ρ i xor ( C mod 2 18 )) + 11 ] / 2 17 ⌋
中间位分组与掩码
符号 含义 定义或约定 g g g 中间位组编号 0 ≤ g < 8192 0\le g<8192 0 ≤ g < 8192 b a s e \mathrm{base} base 一组中间位的组首值 256 ⌊ g / 16 ⌋ + ( g m o d 16 ) 256\lfloor g/16\rfloor+(g\bmod16) 256 ⌊ g /16 ⌋ + ( g mod 16 ) j j j 组内候选编号 0 ≤ j < 16 0\le j<16 0 ≤ j < 16 j j j m j m_j m j 组内第 j j j b a s e + 16 j \mathrm{base}+16j base + 16 j γ i \gamma_i γ i 第 i i i μ i + b a s e \mu_i+\mathrm{base} μ i + base j j j γ i + 16 j \gamma_i+16j γ i + 16 j o f f s e t i \mathrm{offset}_i offset i 组首输入在当前 256 区间内的偏移 γ i m o d 256 \gamma_i\bmod256 γ i mod 256 c u t i \mathrm{cut}_i cut i 首次到达或跨过下一个 256 边界的候选编号 ⌈ ( 256 − o f f s e t i ) / 16 ⌉ \lceil(256-\mathrm{offset}_i)/16\rceil ⌈( 256 − offset i ) /16 ⌉ f r o n t i \mathrm{front}_i front i 前段候选的掩码 2 c u t i − 1 2^{\mathrm{cut}_i}-1 2 cut i − 1 b a c k i \mathrm{back}_i back i 后段候选的掩码 0 x f f f f x o r f r o n t i \mathtt{0xffff}\mathbin{\mathrm{xor}}\mathrm{front}_i 0xffff xor front i m a s k \mathrm{mask} mask 各格允许掩码的累计交集 初始为 0xffff;第 j j j m j m_j m j
高位换元与区间求交
符号 含义 定义或约定 r i r_i r i 基准输出的低 18 位 q ˉ i m o d 2 18 \bar q_i\bmod2^{18} q ˉ i mod 2 18 b i b_i b i 基准输出的高 13 位 ⌊ q ˉ i / 2 18 ⌋ \lfloor\bar q_i/2^{18}\rfloor ⌊ q ˉ i / 2 18 ⌋ q ˉ i = r i + 2 18 b i \bar q_i=r_i+2^{18}b_i q ˉ i = r i + 2 18 b i θ \theta θ 高位 h h h A h m o d 8192 Ah\bmod8192 A h mod 8192 h = 4965 θ m o d 8192 h=4965\theta\bmod8192 h = 4965 θ mod 8192 ϕ i \phi_i ϕ i 换元后的输出高 13 位 ( b i + θ ) m o d 8192 (b_i+\theta)\bmod8192 ( b i + θ ) mod 8192 τ i \tau_i τ i b i + θ b_i+\theta b i + θ 8192 − b i 8192-b_i 8192 − b i η \eta η θ \theta θ θ m o d 5 \theta\bmod5 θ mod 5 I i , η I_{i,\eta} I i , η 第 i i i η \eta η 按单格条件取 [ 0 , τ i ) [0,\tau_i) [ 0 , τ i ) [ τ i , 8192 ) [\tau_i,8192) [ τ i , 8192 ) ∅ \varnothing ∅ I η I_\eta I η 所有格子对余数类 η \eta η ⋂ i I i , η \bigcap_i I_{i,\eta} ⋂ i I i , η θ m o d 5 = η \theta\bmod5=\eta θ mod 5 = η l o , h i \mathrm{lo},\mathrm{hi} lo , hi 非空交集区间的下界、上界 I η = [ l o , h i ) I_\eta=[\mathrm{lo},\mathrm{hi}) I η = [ lo , hi ) θ min \theta_{\min} θ m i n 从区间下界起第一个满足余数要求的整数 l o + ( ( η − l o ) m o d 5 ) \mathrm{lo}+((\eta-\mathrm{lo})\bmod5) lo + (( η − lo ) mod 5 ) h i \mathrm{hi} hi
固定常量
符号或数值 用途 数值或关系 M M M Java Random 的状态空间大小与状态更新模数 2 48 2^{48} 2 48 A A A Java Random 状态更新的乘数 0 x 5 D E E C E 66 D \mathtt{0x5DEECE66D} 0x5DEECE66D 11 11 11 Java Random 状态更新的加数 v = ( A u + 11 ) m o d 2 48 v=(Au+11)\bmod2^{48} v = ( A u + 11 ) mod 2 48 987234911 987234911 987234911 史莱姆公式中的 XOR 常量 与 Random 初始化的 XOR 常量 A A A C C C C C C 合并后的初始化 XOR 常量 A x o r 987234911 = 0 x 5 E 434 E 432 < 2 35 A\mathbin{\mathrm{xor}}987234911=\mathtt{0x5E434E432}<2^{35} A xor 987234911 = 0x5E434E432 < 2 35 E E E 预计算公式中的高位 XOR 常量 C ≫ 18 = 0 x 1790 d C\gg18=\mathtt{0x1790d} C ≫ 18 = 0x1790d 4987142 , 5947611 4987142,5947611 4987142 , 5947611 X 轴坐标系数 分别用于 F ( x ) F(x) F ( x ) 4392871 , 389711 4392871,389711 4392871 , 389711 Z 轴坐标系数 分别用于 G ( z ) G(z) G ( z ) 1645 1645 1645 A A A A m o d 8192 = 1645 A\bmod8192=1645 A mod 8192 = 1645 4965 4965 4965 A A A 1645 × 4965 ≡ 1 ( m o d 8192 ) 1645\times4965\equiv1\pmod{8192} 1645 × 4965 ≡ 1 ( mod 8192 )
感谢 @guwu_Dx 提供的算力支持。
本文使用的算法由 AI 整理、验证。